Vendégcikk: Mohammad Bahrololoum, ex EP2MHB
Az angol eredeti fordítása, szerző: Mohammad Bahrololoum. Az angol eredetihez
A morzekódot gyakran univerzális nyelvnek nevezik. A dah dah Bécsben, Dubaiban és Teheránban is. Az anyagok azonban, amelyekből tanítják, nem univerzálisak. Szinte mind angolul íródott, a többség pedig más európai nyelveken. Aki perzsául vagy arabul beszél, és a saját nyelvén szeretne CW-t tanulni, nagyon keveset talál.
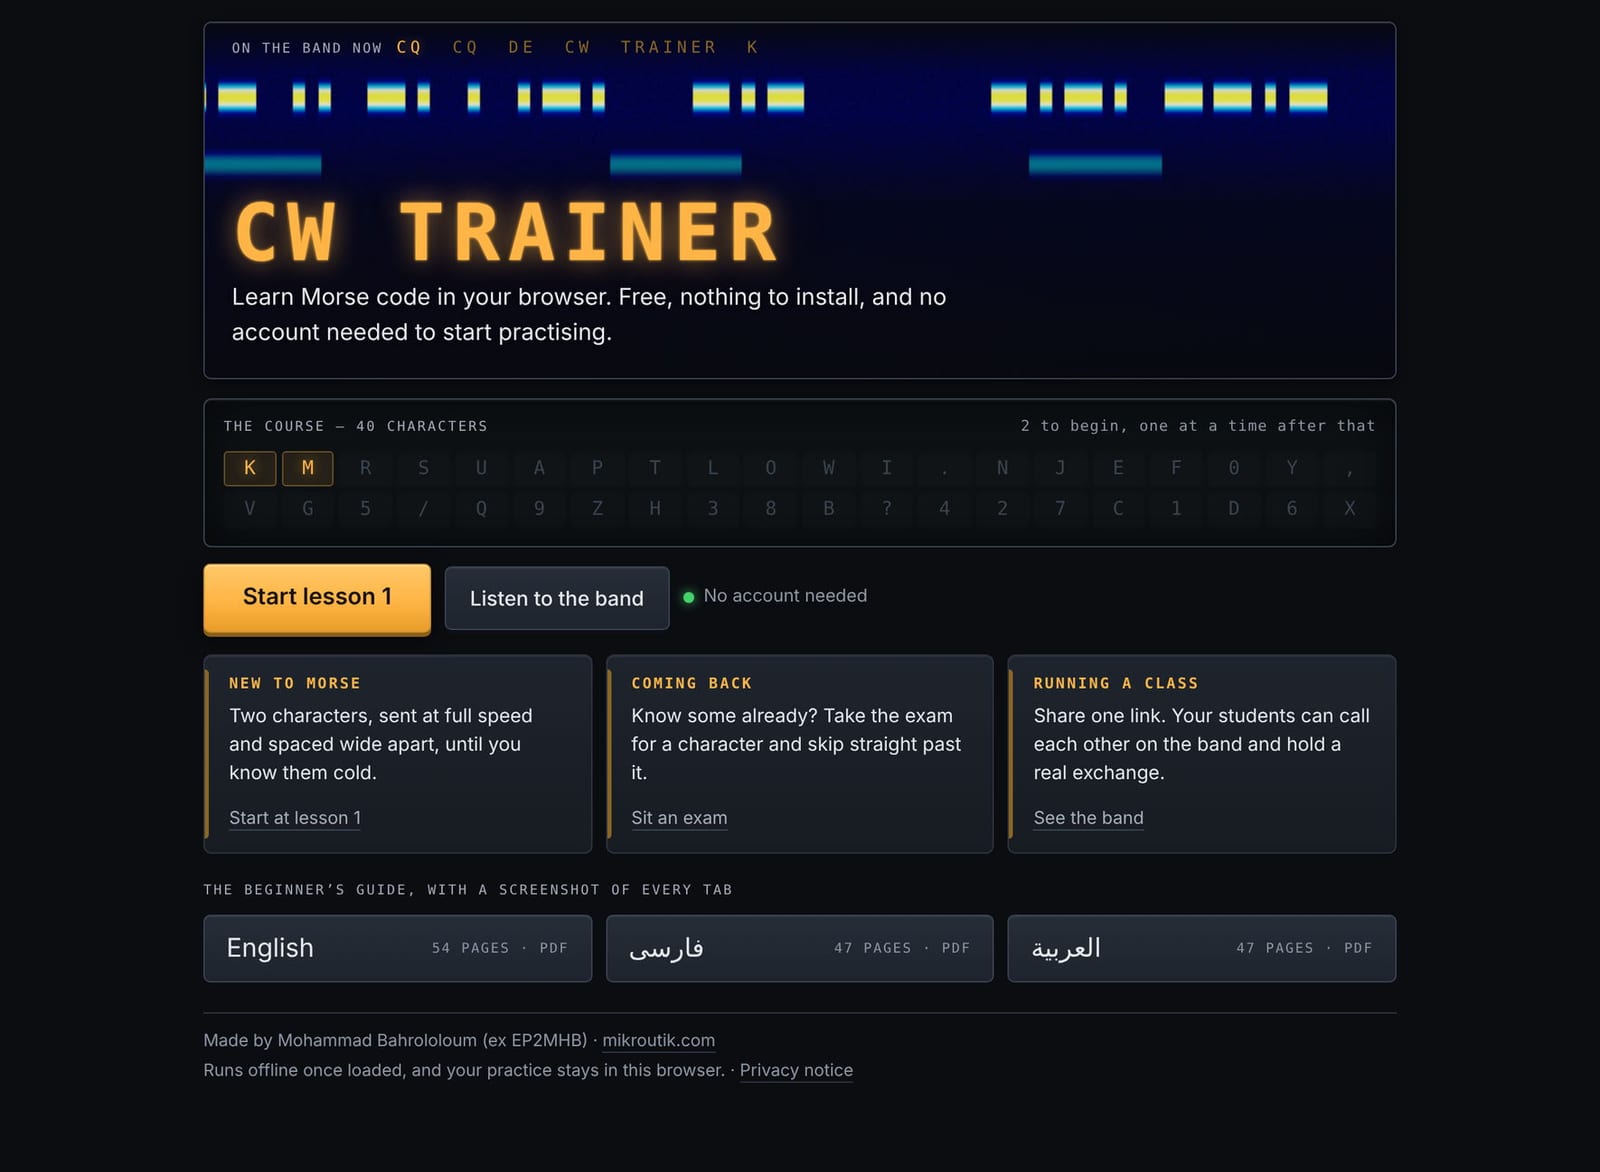
Egy ingyenes, böngészőben futó CW-tréner, a CW Trainer (cw.mikroutik.com) karbantartója vagyok, és idén ősszel megírtam a kézikönyvét három nyelven: angolul, perzsául és arabul, összesen mintegy 150 oldalban. Azt vártam, hogy a fordítás lesz a fő munka. Ez volt a kisebbik rész. Az alábbiakban azokról a problémákról írok, amelyekre nem számítottam, abban a reményben, hogy aki legközelebb ilyesmire vállalkozik, korábban észreveszi őket.
Az eredetiből fordítsunk, soha ne egy testvérkiadásból
Először az angol kézikönyv készült el, aztán a perzsa, majd az arab. Az arab szöveg fordítása az angolból történt, fejezetről fejezetre, ahogy az illik. A perzsa kiadás azonban már kész volt és ki volt tördelve, ezért szerkezeti sablonként használták: a fejezetek sorrendje, a címsorok, minden fejezetcím mintája.
Ez a sablon átvitt magával egy szót. Perzsául a felhasználói felület egyik tabja زبانه (olvasd: Zabaneh), szó szerint „kis nyelv”. Ez helyes perzsa szó. A fejezetcímek mintája változtatás nélkül átvitte az arabba لسان (olvasd: Lesan) alakban, ami szintén „nyelvet” jelent, és semmi mást. A felület tabjának arab szava تبويب (olvasd: Tabweeb).
48-szor fordult elő, minden tabról szóló fejezet minden címsorában. A kézikönyv leggyakrabban ismételt főneve volt. Minden automatikus ellenőrzés sikeres volt: a fájl feldolgozódott, a PDF elkészült, az ábrák számozva voltak, a szerkezet pedig sorról sorra egyezett a másik két kiadással. Egyetlen oldal olvasása közben vettem észre, amikor megkérdeztem magamtól, mit keres a „nyelv” minden bekezdés elején.
Egy korábbi fordításból átvett tükörfordítás a fordító számára láthatatlan, az olvasó számára viszont szembetűnő. A tanulság, amelyet ebből levontam, egyszerű: az eredetiből fordítsunk, a testvérkiadást pedig csak az elrendezéshez használjuk, soha ne szóválasztásra.
A vezérlőelemek nevét latin betűkkel hagyjuk meg, aztán fizessünk érte
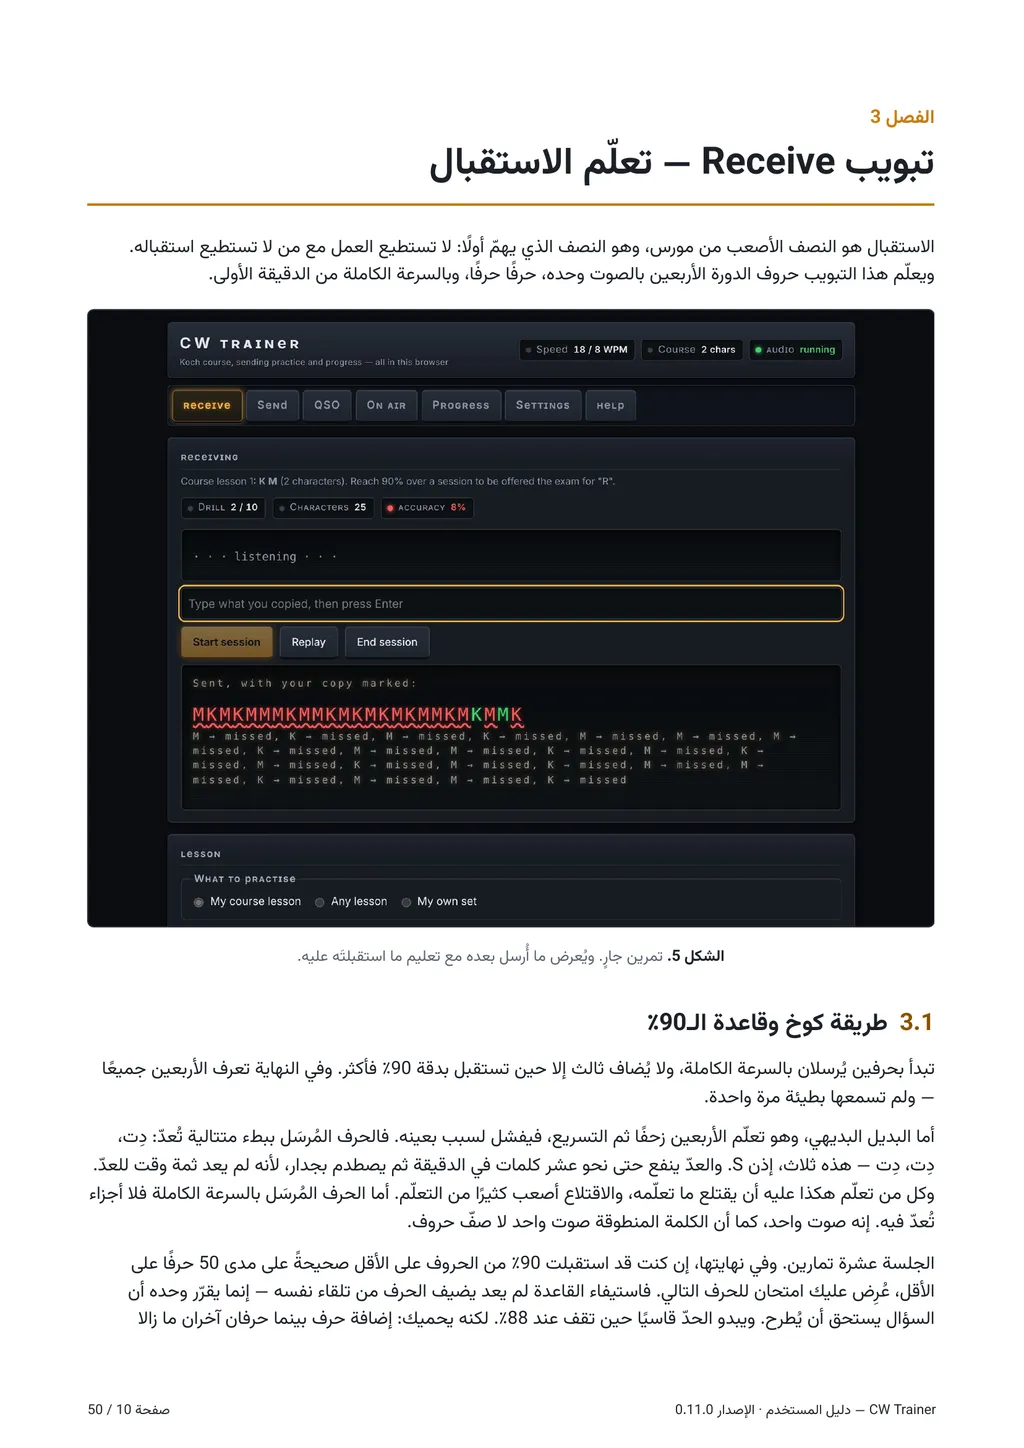
A kézikönyvnek meg kell mondania az olvasónak, melyik gombot nyomja meg. Ha a képernyőn Receive áll, a kézikönyv pedig azt írja: دریافت (olvasd: Daryaft), az olvasónak vissza kell fordítania, mielőtt megtalálja a gombot. Ezért a perzsa és az arab kiadás is minden vezérlőelem nevét pontosan úgy hagyja meg latin betűkkel, ahogyan a képernyőn szerepel.
Ennek a döntésnek ára van. A perzsa vagy arab bekezdés jobbról balra fut. Ha beleteszünk egy angol szót, a Unicode kétirányú algoritmusának kell eldöntenie, hogy a szomszédos karakterek melyik irányba tartoznak. A központozás az általános áldozat: egy pont vagy záró zárójel egy angol szó mellett rossz oldalra kerülhet. Egy hívójel vagy egy olyan érték, mint a „20 WPM”, úgy rendeződhet át, hogy rosszul olvasható, miközben szinte helyesnek látszik.
A megoldás az, hogy minden balról jobbra haladó töredéket kifejezetten elkülönítünk, hogy a bekezdés mindegyiket lezárt egységként kezelje, ne találgasson. A kézikönyv összeállításában ez azt jelenti, hogy minden vezérlőelem-név, billentyű, kódrészlet és hívójel be van csomagolva, és elkülönített balról jobbra szövegként van megjelölve. Tegyük ezt meg minden töredékkel az elejétől fogva. Egyenként javítgatni őket, ahogy a panaszok érkeznek, soha nem ér véget.
A betűtípus fontosabb, mint gondolnánk
A perzsa és az arab osztozik az íráson, ezért kézenfekvő, hogy mindkettőt egy betűtípussal szedjük. Először mindkettőhöz a Vazirmatnt használtam, ami kiváló perzsa betűtípus. Az arab szöveget helyesen jeleníti meg: minden betű ott van, és minden szó helyesen kapcsolódik.
De perzsa betűformákkal rajzolja meg. Több betű és a számjegyek is másként néznek ki a két hagyományban, és az arab olvasó azonnal észreveszi. Az oldal úgy hat, mint perzsa tipográfia, amely arab szavakat visel. Az arab kiadás most Noto Sans Arabic betűtípussal van szedve, a perzsa Vazirmatnban marad. Az írásrendszer kiválasztása nem elég; olyan betűtípust válasszunk, amelyet az adott nyelvre készítettek.
Számjegyek
Az arabnak saját számjegyei vannak, ٠١٢٣٤٥٦٧٨٩, a perzsának pedig egy rokon, de eltérő készlete. A kézenfekvő választás az lenne, hogy mindenhol ezeket használjuk. Az arab kiadás nem így tesz. Nyugati számjegyeket használ, 0-tól 9-ig.
Két oka van. Először is követi az öbölbeli műszaki írás konvencióját, ahol a kiadást valószínűleg olvasni fogják. Másodszor, egy CW-kézikönyvben a számok szinte soha nem állnak egyedül. Latin értékek mellett állnak: 20 WPM, egy 599-es riport, egy olyan hívójel, mint az A61XX. Két számjegyrendszert keverni egyetlen információcserén belül nehezebben olvasható, mint egyet használni. Műszaki anyagokban a szakterület konvenciója felülmúlhatja a nyelvét.
Mindezek alatt: a morze független az írásrendszertől, a Koch-sorrend nem
Ezt a pontot szeretném a legjobban, ha az emberek megjegyeznék.
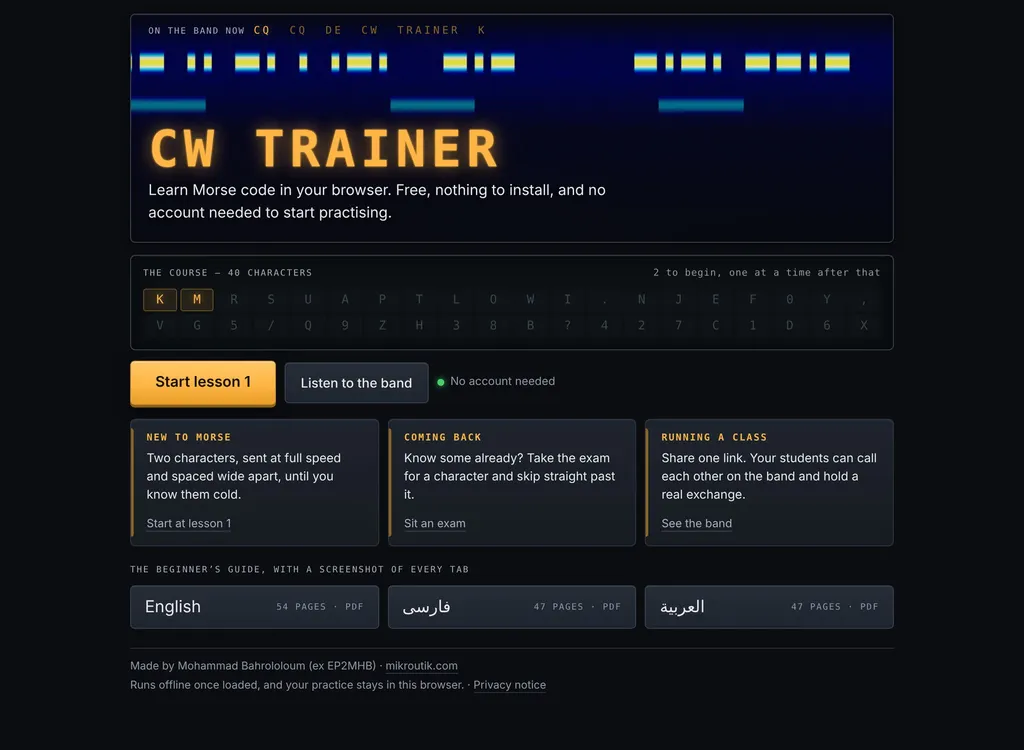
A Koch-módszer a karaktereket egyenként vezeti be, teljes sebességgel, rögzített sorrendben. A trénerem a G4FON Koch-trénerének 40 karakteres sorrendjét használja, amely K, M, R, S, U-val kezdődik; mások, köztük az LCWO, saját sorrendet használnak. Ezek a sorrendek azonban mind latin betűk sorozatai, és az információcserék, amelyekre edzünk (hívójelek, RST, Q-kódok, nevek és QTH-k), szintén latin betűkkel íródnak.
A perzsának és az arabnak megvan a saját morzeábécéje. A rádióamatőrök nem használják őket. Így aki angolul beszél és CW-t tanul, egy dolgot tanul: kódot olyan betűkhöz, amelyeket már ismer. Aki perzsául vagy arabul beszél, két dolgot tanul egyszerre: a kódot és a latin betűket, amelyeket jelöl, azzal a szokással együtt, hogy balról jobbra olvassa őket. Amikor egy tanuló leveszi a „K”-t, és nem tudja hanghoz kötni, a gond lehet, hogy nem a morzéval van.
Mindettől nem lesz nehezebb a tanfolyamot elkészíteni. A magyarázat lesz fontosabb. A perzsa és arab kézikönyvnek az ábécét éppúgy el kell magyaráznia, mint a kódot, mégpedig anélkül, hogy lekezelően bánna valakivel, aki akár tapasztalt mérnök is lehet, és egy második írásrendszerben olvas.
Mit mondanék a következőnek
- Minden kiadást az eredetiből fordítsunk, soha ne más fordításból.
- A képernyőn látható neveket abban az írásrendszerben hagyjuk meg, amelyet a képernyő használ, és minden balról jobbra haladó töredéket az elejétől fogva különítsünk el.
- Olyan betűtípust válasszunk, amelyet a nyelvre terveztek, nem csak az írásrendszerre.
- A számjegyeket a szakterület konvenciója szerint döntsük el, éppúgy, mint a nyelv szerint.
- Ne feledjük, hogy az olvasó lehet, hogy ábécét tanul, nem csak kódot.
- És keressünk egy anyanyelvi operátort, aki elolvassa. Az arab kiadásom még vár erre az olvasásra, és örülnék neki.
A CW Trainer ingyenes, nincs benne hirdetés, és a gyakorláshoz nem kell fiók. A forráskódja nyílt (github.com/ep3mhb/cw-trainer), a kézikönyv pedig mindhárom nyelven elérhető a „Help” fülről.
Kapcsolódó: Learning CW in 2026: Modern Training Methods with Apps, Web Tools, and AI