Kazalo vsebine
- Problem: CW v težkih pogojih
- Rešitev: nevralne mreže za CW
- Kako deluje dekodiranje CW na osnovi AI?
- 1. Predhodna obdelava zvoka
- 2. Generiranje spektrograma
- 3. Ekstrakcija lastnosti s CNN
- 4. Obdelava zaporedij z RNN
- 5. Izhod in popravljanje napak
- Orodja in projekti
- Zaključek
- Viri in nadaljnje povezave
- Obvestilo o preglednosti
Morsejeva koda — CW — je najstarejši digitalni način v radioamaterstvu. Generacije izkušenih radioamaterjev so obvladali umetnost dekodiranja pik in črt na sluh. Toda kaj se zgodi, ko strojno učenje prevzame to nalogo? Moderne nevralne mreže lahko dekodirajo CW signale v realnem času — tudi v ekstremnih pogojih: šum, QRM, fading. Ta članek prikazuje, kako delujejo dekodirniki CW, ki temeljijo na AI, katera orodja so na voljo in kje so meje.
Problem: CW v težkih pogojih
Dekodiranje CW je izziv za človeški možgani — posebej ko se kombinira več dejavnikov:
- Šibki signali: Med QRP delovanjem ali slabimi pogoji širjenja signal izgine v šumu
- QRM (motnje): Več postaj na podobnih frekvencah, motnje od plazemskih zaslonov ali preklopnih napajalnikov
- QSB (fading): Signal nenehno niha v jakosti, pike in črte je težko razlikovati
- Chirp: Nestabilni oscilatorji v starejših oddajnikih ustvarjajo tone s spreminjajočo frekvenco
- Spremenljiva hitrost: Ročno manipulirani CW nima popolnoma enakomerne hitrosti
Klasični dekodirniki CW, kot so Goertzelov algoritem ali hitra Fourierjeva transformacija (FFT), dobro delujejo s čistimi signali. Toda takoj ko se dodajo močan šum ali motnje, stopnja napak dramatično naraste.
Rešitev: nevralne mreže za CW
Nevralne mreže — zlasti Convolutional Neural Networks (CNN) in Recurrent Neural Networks (RNN) — so idealno primerne za dekodiranje CW:
- CNN analizirajo avdio spektrogram (časovno-frekvenčna predstavitev) in prepoznavajo vzorce v vizualnih podatkih — podobno kot pri prepoznavanju slik
- RNN (npr. LSTM — Long Short-Term Memory) obdelujejo časovne sekvence in se učijo strukture morsejevih črk in besed
- Transformer modeli: Najbolj moderna različica uporablja mehanizme pozornosti za razumevanje konteksta in odvisnosti med znaki
Posebnost: te mreže so trenirane na tisočih vzorcev CW — z različnimi hitrostmi, ravnmi šuma in motnjami. Tako se naučijo zanesljivo dekodirati tudi v neugodnih pogojih.
Kako deluje dekodiranje CW na osnovi AI?
1. Predhodna obdelava zvoka
Signal CW se odvzame iz transceiverja kot avdio tok (tipično frekvenca stranskega tona 600-1000 Hz). Zmanjševanje šuma na osnovi AI se lahko že uporabi vnaprej.
2. Generiranje spektrograma
Zvok se pretvori v spektrogram — 2D sliko, kjer os X predstavlja čas in os Y predstavlja frekvenco. Morsejeve pike in črte se pojavijo kot svetle palice različnih dolžin.
3. Ekstrakcija lastnosti s CNN
CNN analizira spektrogram in ekstrahira lastnosti — tipične vzorce pik, črt in pavz. Mreža samodejno filtrira šum in moteče signale.
4. Obdelava zaporedij z RNN
Ekstrahirane lastnosti se posredujejo RNN, ki analizira časovno zaporedje. Mreža prepozna: "pika-pika-pika = E", "črta-pika-črta-pika = C" itd.
5. Izhod in popravljanje napak
Dekodirani znak se izda. Moderni sistemi dodatno uporabljajo jezikovne modele (kot samodejno popravljanje na pametnih telefonih) za odkrivanje in popravljanje tipkarskih napak: "HXLLO" postane "HELLO".
Orodja in projekti
Najprej: najbolj znani klasični dekodirniki CW niso nevronske mreže. Nevronski dekodirniki so zdaj predvsem odprtokodni projekti in poskusi, ki sledijo istemu osnovnemu receptu: spektrogram, CNN, rekurentna mreža ali Conformer, izhod CTC.
DeepCW je odprtokodni projekt uporabnika GitHub e04: nevronski dekodirnik v realnem času za Windows, macOS, Android in iOS ter spletni demo na deepcw.cc. Razvijalci objavljajo lasten preizkus (aditivni beli šum, pasovna širina šuma 2500 Hz): 0,00 % napak med 0 in -4 dB SNR, pod 1,5 % pri -8 dB in pod 8 % pri -10 dB. To so podatki proizvajalca v laboratorijskih pogojih, ne neodvisen test.
deepmorse-decoder avtorja Maurija Niininena, AG1LE, je projekt v Pythonu z modelom CNN-LSTM-CTC (GPL-3.0). Drugi poskusi so MorseNet, nn-morse in DeepFist. Naslednji video predstavlja projekt univerze Technion (v angleščini):
Za primerjavo: CW Skimmer (VE3NEA, Afreet Software) uporablja zelo občutljiv algoritem na osnovi Bayesove statistike, torej ni nevronska mreža, in je osnova Reverse Beacon Network. fldigi ima vgrajen klasični dekodirnik CW; vtičnika AI za fldigi po naših raziskavah ni. Več o CW Skimmer (v angleščini):
Neodvisne primerjave med dekodirniki AI, klasičnimi dekodirniki in človeškim sluhom so redke. Odstotki iz datotek README večinoma izhajajo iz sintetičnega šuma in jih ni mogoče neposredno prenesti na prave pasove s QRM, QSB in ročno tipkanim CW. Kako težki so pravi signali, kaže tudi video Davida Caslerja z naslovom »Machine Decoding of Morse Code is an Unsolved Problem« (v angleščini):
Zaključek
Dekodirniki CW na osnovi AI niso več znanstvena fantastika — delujejo danes. Po preizkusih samih projektov premagajo klasične algoritme predvsem pri šibkih, šumnih signalih, neodvisno pa to skoraj ni preverjeno. Za uporabo na tekmovanjih, kot učne pripomočke ali za dostopnost so dragocena orodja. Ali bi morali nadomestiti ročno kopiranje CW, je filozofsko vprašanje. Eno je gotovo: tehnologija obstaja — in postaja boljša.
Kot pri ChatGPT in Claude kot pomočnikih postaje, velja tudi tu: AI je orodje, ne nadomestek za lastno kompetenco. Kdor želi naučiti se CW, naj še naprej sam posluša in manipulira. Toda ko signal izgine v šumu, je pomirjujoče vedeti, da AI morda še lahko sliši nekaj, kar človeško uho ne more več zaznati.
Viri in nadaljnje povezave
- DeepCW (GitHub, e04) in spletni demo deepcw.cc
- deepmorse-decoder (GitHub, AG1LE), MorseNet, nn-morse, DeepFist, projekt Technion
- CW Skimmer (Afreet Software, VE3NEA) in Wikipedia: CW Skimmer
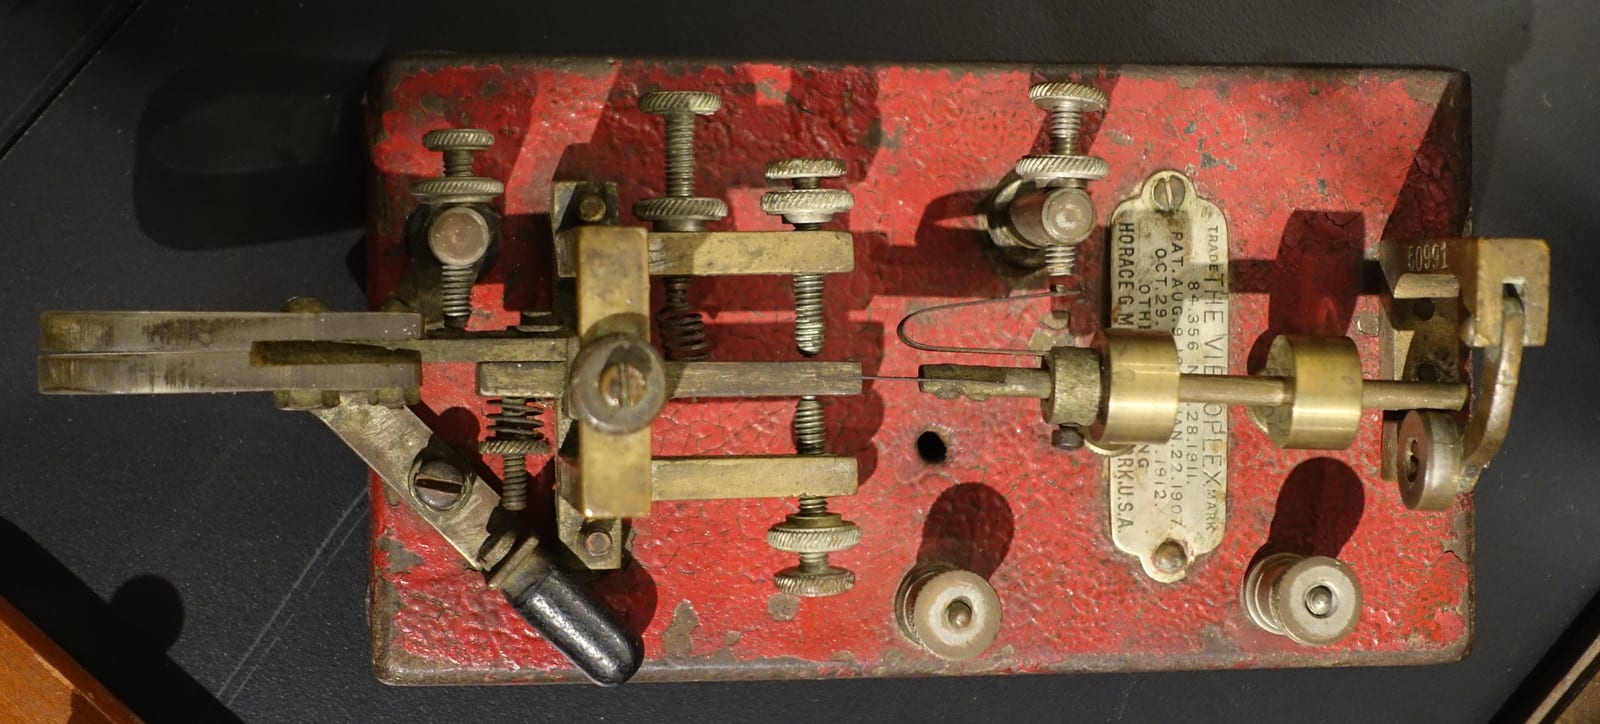
- Naslovna slika: ključ Vibroplex, National Electronics Museum, foto Daderot, Wikimedia Commons (CC0)
73 – vaše oeradio.at-uredništvo
Obvestilo o preglednosti
Ta članek je bil raziskan in napisan s pomočjo umetne inteligence (Claude, Anthropic). Uredništvo je pregledalo in uredilo vso vsebino. Kljub skrbnemu pregledu se lahko pojavijo posamezne netočnosti — z veseljem sprejemamo popravke po e-pošti na [email protected].